Как я 4 раза проиграл
локальным моделям
Живой тест 7 моделей на данных центра здоровья. Замеры, провалы, деньги и решения, которые пришлось принимать по цифрам, а не по убеждению
Что вы отсюда унесёте
Звук в текст
Три движка распознавания на одной записи. Кто быстрее в 8 раз и почему я всё равно остался на медленном
4 провала подряд
Четыре локальные модели, четыре разные причины отказа. Как распознать каждую за минуту вместо дня
Чем мерить модели
Как собрать линейку, которая не подстраивается под результат. И 3 дыры, которые остались в моей
Сообщение, которое отменило мои цифры
2 недели я улучшал показатели, а продукт становился хуже. Как я это узнал и что делал дальше
Деньги, данные и кто находит поломки
Разброс цены в 150 раз. Почему ни одна модель у шлюза не имеет нужной отметки. И счёт, которым я не горжусь
Что с собой
Участвуем: отвечаем в чат, голосуем, проверяем память в симуляторе и собираем бинго
2 файла: чек-лист проверки модели и правила для вашего ИИ-агента
Евгений Ганимар
ИТ-предприниматель и маркетолог-практик. Строю работающие ИИ-системы под конкретный бизнес и сам их довожу до боя, а не отдаю красивые презентации
Веду каналы про ИИ в работе и разбираю чужие проекты. Сегодняшний кейс - 1 из десятка, где приходилось выбирать между удобным и допустимым
Час разговора на входе, готовая карточка на выходе
Специалист центра здоровья проводит сессию. После неё надиктовывает разбор на телефон. Дальше начинается то, за что мне заплатили
- Было: специалист сводила карточку руками после каждой сессии. Сколько именно минут - я не замерил, и это моя ошибка. К ней вернёмся в конце
- Надо: не больше 5 минут её участия. Это записанный критерий приёмки проекта
- Карточка это 13 разделов и 30 полей. Их надо заполнить словами клиента, а не своими
Реальный интерфейс сервиса с вымышленными демо-данными
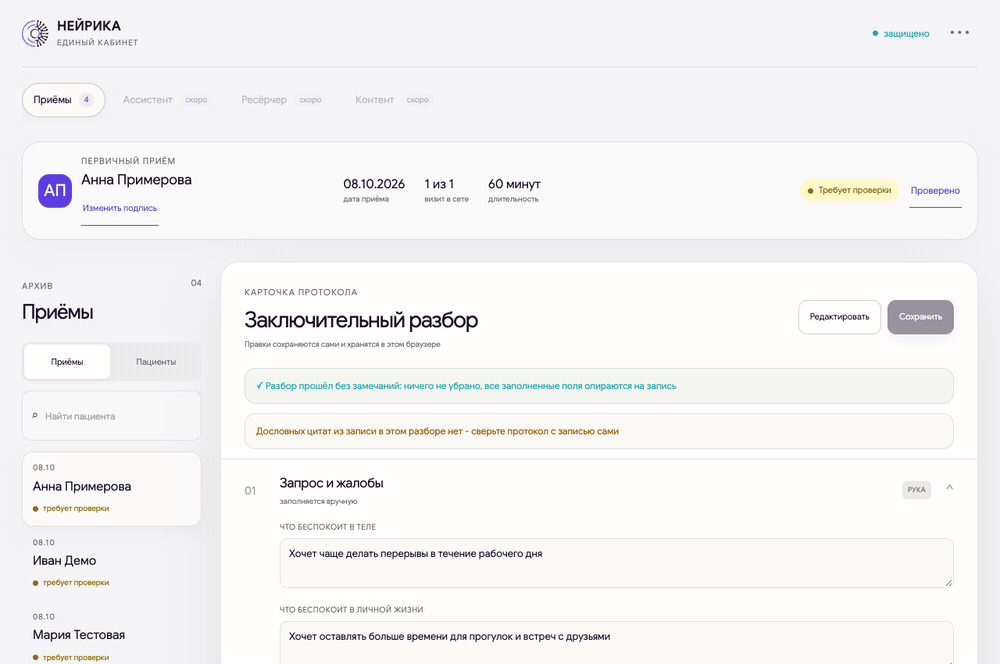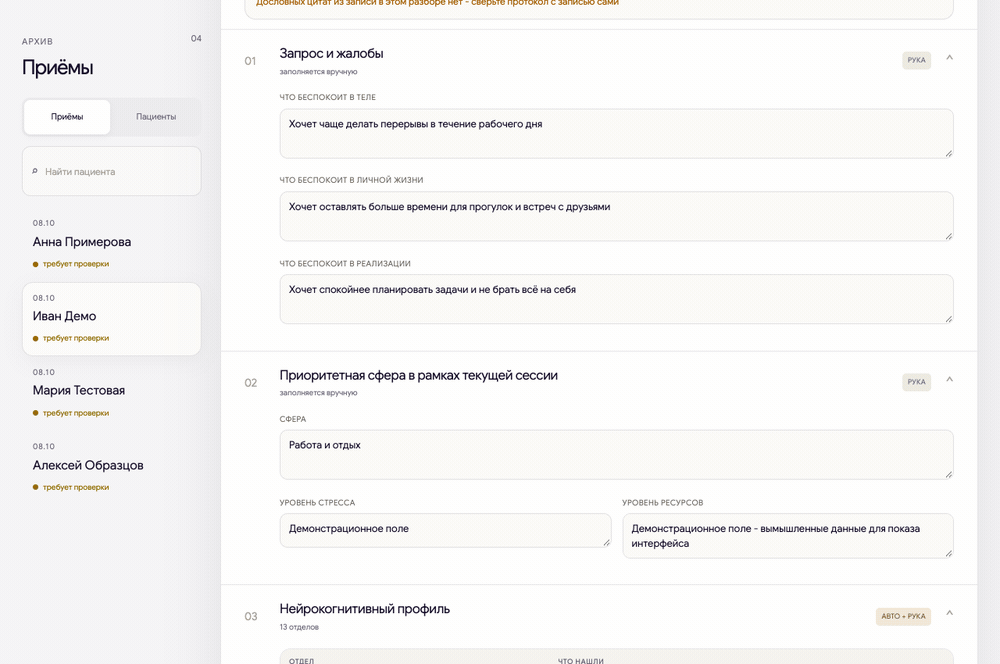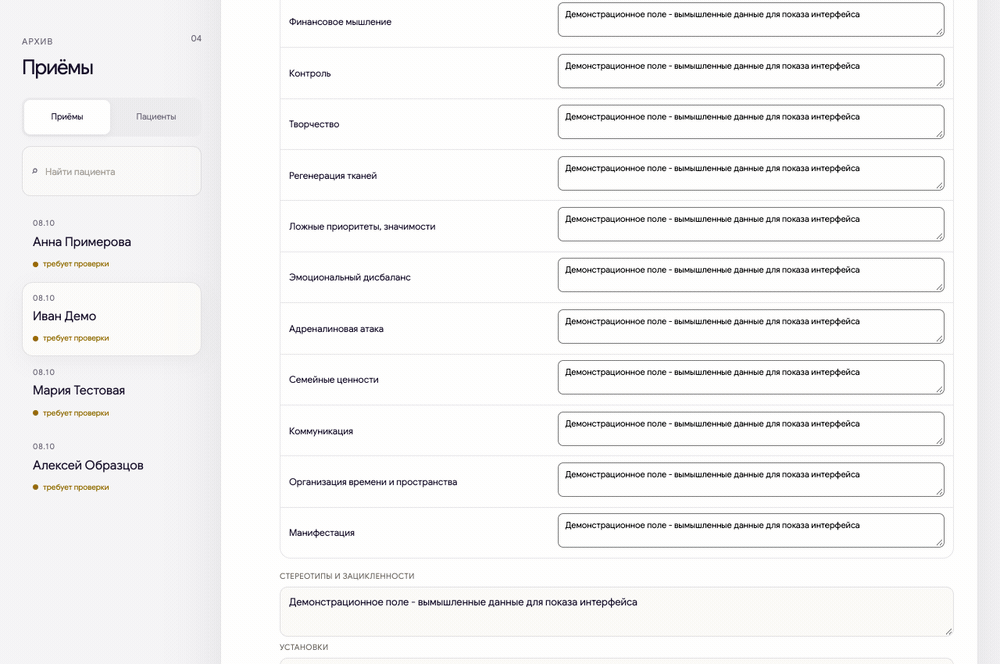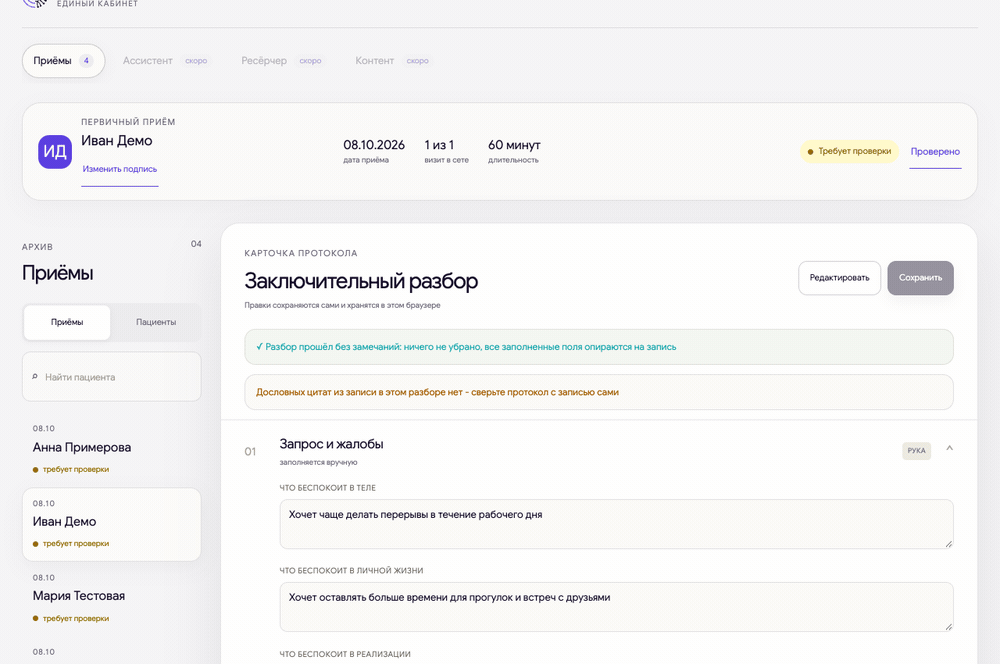
Кабинет для карточек, бот - чтобы держать руку на пульсе
В проекте есть бот: он помогает мне отслеживать статус работы и общаться со специалистом / экспертом
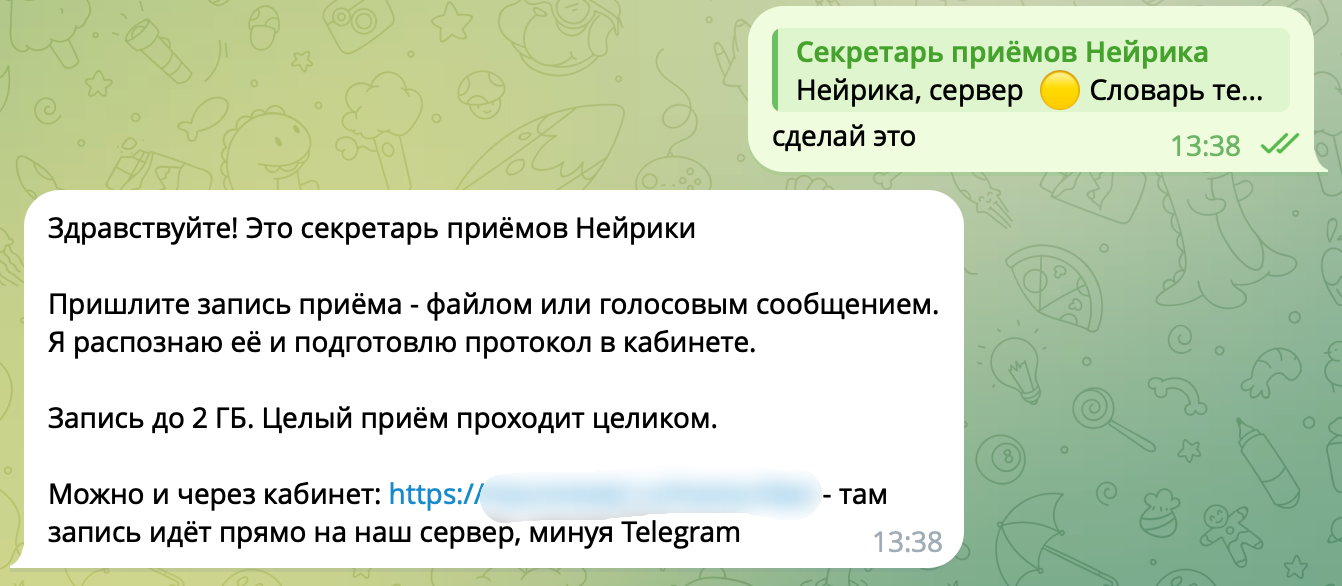
Почему нельзя просто вставить это в чат с ИИ
В записи звучат имя клиента, его личные обстоятельства и его голос. Это данные человека, который доверил их специалисту, а не мне и не чужому сервису
- Имена и личные обстоятельства в каждой записи
- Голос в каждом аудиофайле: его нельзя заменить на условное обозначение, он сам по себе и есть человек
- Согласие клиента на обработку: без него запись не уходит никуда
Здесь ломается не сервис, а репутация
В обычном проекте сбой стоит времени. Здесь он стоит доверия клиентов к центру, который их записывал. Отыграть это назад нельзя, поэтому всё, что дальше, решалось замером, а не мнением
Как я после этого принимал каждое решение
Каждый шаг я гонял через один вопрос: что уходит наружу. Не «удобно ли», не «дёшево ли», а какие именно данные покидают контур и кому. Дальше вы увидите, как этот вопрос четыре раза подряд запретил мне удобное
Модель разбирает разговор. Имена ей знать незачем
Я встроил в сервис слой маскирования персональных данных. Он готовит текст для внешней модели и возвращает имена в готовую карточку уже на нашем сервере
До отправки
«Обсуждала ситуацию с Александром Сергеевичем Ковалёвым. Написать ему: demo@example.com»
После замены
«Обсуждала ситуацию с [ЛИЦО_1]. Написать ему: [КОНТАКТ_1]»
Пример вымышленный, он показывает только принцип замены. Настоящие записи клиентов на слайдах не показываются.
[ЛИЦО_1] и [КОНТАКТ_1] - условные метки в примере, не криптографические токены
Смысл разговора остаётся, прямые идентификаторы заменяются
Одинаковая метка обозначает того же человека во всех частях записи. Родственные роли сохраняются: модель может разбирать отношения, не зная имён
Для специалиста всё привычно: в кабинете он получает карточку с именами, а не набор меток
Защита работает до того, как модель получит текст
Карточка + правила + локальное распознавание
Имена из карточки ищем с учётом падежей. Телефоны, почту и номера документов ловят правила. Имена, места и организации дополнительно ищет локальный распознаватель
Нашли остатки - остановили запрос
Отдельная проверка ищет пропущенные данные. Если она сработала, внешний вызов блокируется. Без подтверждённого согласия он тоже не выполняется
Модель получает текст с метками
Таблица соответствий остаётся в памяти процесса на нашем сервере. Она нужна для обратной подстановки и не отправляется модели
Готовая карточка - внутри сервиса
Сервис подставляет исходные данные в ответ до показа специалисту. Ему не нужно вручную скрывать имена перед каждым разбором и восстанавливать их после
Мой вклад - соединить защиту данных и рабочий процесс в одном сервисе
Замены обратимы и не гарантируют полную анонимность: человека иногда можно узнать по контексту. Поэтому маскирование, проверка и согласие - отдельные части процесса
3 места, где может считаться ИИ
Локально, на своём сервере
Данные не покидают контур вообще. Ноль рублей за каждый запрос. Звучит как очевидный ответ, и я начал с него
ничего не уходитРоссийское облако
Текст уходит к провайдеру внутри страны. Вопрос один, и он неудобный: что провайдер делает с текстом запроса
нужен ответ про хранениеЗарубежное облако
Лучшие модели рынка. Отправлять можно только то, из чего заранее вырезаны все имена и приметы
только обезличенноеЗадача делится на 2 части, и ответ у них разный: сначала звук превратить в текст, потом текст разложить по разделам
Сначала надо услышать
Прежде чем разбирать текст, звук надо превратить в текст. Здесь решается, можно ли вообще выпускать эти данные из контура
Сначала надо услышать, потом разбирать
Про этот шаг обычно не рассказывают, хотя именно здесь решается судьба всего проекта. Плохо распознали - дальше разбирать нечего, сколько ни плати за умную модель
Голос обезличить нельзя
В тексте я заменяю имя на условное обозначение, и наружу уходит безликая строка. С голосом так не выйдет: сам звук и есть примета человека. Значит распознавание обязано считаться у нас
Три движка распознавания: разница в 8 раз
| Движок | Время | Доля от длины записи | Слов | Знаков препинания | Вес на диске |
|---|---|---|---|---|---|
| large-v3-turbo в бою | 128 с | 0,54 | 577 | 0 | 1,6 ГБ |
| whisper small | 68 с | 0,28 | 619 | 207 | 464 МБ |
| GigaAM v3 кандидат | 15 с | 0,06 | 585 | 133 | 216 МБ |
Все 3 движка считаются локально, то есть звук никуда не уходит ни в одном из вариантов. Выбор идёт только между скоростью и качеством
Быстрейший движок до сих пор не в бою, и это осознанно
GigaAM v3 лежит на сервере как кандидат. В бою остался медленный large-v3-turbo, потому что замер мерил скорость, а не правильность. Чей текст ближе к сказанному, цифрами не определяется: эталона, вычитанного человеком, у проекта нет. Решает одна проверка на полчаса - специалист читает 2 текста одной записи без подписи, какой чей. Эта проверка не сделана до сих пор, а ошибка здесь стоит дорого
Быстрее в 8 раз, а поставить не могу
Замер сравнивал тексты движков между собой. Оба кандидата разошлись с нынешним примерно одинаково: 20,4% и 20,7%
Слабый и сильный разошлись одинаково
Значит расхождение это мера различия, а не мера правоты. По нему нельзя сказать, кто ближе к сказанному: для этого нужен эталон, текст, про который точно известно, что он верный
Чем тогда выбирать
Эталона у проекта не было: записи никто не расшифровывал вручную. Остаётся слепая вычитка - одна запись, 2 текста, без подписи, какой чей. Решает специалист, а не я
Странность, которую нельзя терять
У нынешнего движка 0 знаков препинания на 4 минутах речи, у кандидатов 133 и 207. Ноль - подозрительное число: похоже на особенность замера. Я это не перепроверил и держу как открытый вопрос
Пока слепая вычитка не сделана, смена движка - лотерея. Поэтому в бою остался медленный large-v3-turbo, а быстрый лежит кандидатом
Распознавание осталось на своём сервере насовсем
0 ₽ за любое количество записей
Платим только временем сервера: час записи считается 33 минуты. Для сравнения, облачное распознавание того же часа стоило бы от 2,88 ₽ до 42,94 ₽ в зависимости от сервиса
Это не про экономию
Отправить запись в облако значит отправить туда голос человека. Заменить в нём что-то на условное обозначение невозможно. Локальное распознавание - единственный слой, который держит это внутри
Запомните этот вывод. В конце доклада он вернётся и окажется главным итогом всей истории с локальными моделями
В 8,6 раза быстрее. Меняем?
Да, скорость решает
Нет, остаюсь на старом
Сначала сравню качество
Напишите 1, 2 или 3. Представьте: вам показали только замер скорости
Показать разбор после ответов
Сначала проверяем качество на той же записи. Скорость измерили, а правильность слов одним секундомером не проверить
4 провала подряд
Локальная модель на своём сервере: данные не уходят, платить не надо. Я закладывал на это выходные
Гипотеза, которая звучала безупречно
Что было в руках
Сервер: 4 ядра, 6 ГБ памяти, без видеокарты. Обычный недорогой сервер, а не машина для нейросетей. Забегая вперёд: это и есть вся интрига
Что проверяем
Возьмёт ли локальная модель запись сессии в 7383 слова и разложит ли её по 30 полям. Я был уверен, что возьмёт
Сколько я на это закладывал
Выходные. По факту ушло 2 недели и 7,5 часа чистого счёта сервера, из них 1 прогон длиной 6 часов
Какая из 4 моделей дошла до результата?
4 локальные модели, одна и та же запись, один и тот же сервер. Напишите в чат номер модели: 1, 2, 3 или 4. Если думаете, что ни одна, пишите 0
| № | Модель | Вес файла | Память в работе | Окно контекста |
|---|---|---|---|---|
| 1 | qwen2.5:14b | 9,0 ГБ | ~12 ГБ | 32 768 |
| 2 | gemma3:4b | 3,3 ГБ | 4,7 ГБ | 131 072 |
| 3 | ruadapt | 3,3 ГБ | 5,4 ГБ | 262 144 |
| 4 | nemotron-mini | 2,7 ГБ | не дошло до замера | 4 096 |
Эти числа были у меня перед глазами до запуска. Причина отказа видна в последней клетке: на вход нужно от 16 000 токенов - 3 000 кусок сессии, 3 000 промпт и место под ответ, - а окно модели 4 096. Тогда я на эту клетку не посмотрел. Прочерк в памяти значит, что до работы дело не дошло и мерить было нечего
Правильный ответ: ни одна
7,5 часа работы сервера и ни одной готовой карточки. Интересны не сами провалы, а то, что причины оказались разными. Разбираем причины по одной
Модель больше машины
qwen2.5:14b
Первая попытка была на рабочем ноутбуке: 16 ГБ, из них 11,8 ГБ видеопамяти. Модель весит 9 ГБ. Я вычел одно из другого, увидел запас почти в 3 гигабайта и пошёл запускать
- Не влезает: к весу модели прибавляется место под сам текст, а текст длинный. Запаса не было вовсе
- Ответ пришёл не словами «мало памяти», а кодом ошибки 500 через 2 минуты
- Вывод, который стоил дня: на машине с 16 ГБ потолок это модели размером около 7 миллиардов параметров, а не 14
Что я усвоил за этот день
Вес файла модели это не её размер в работе. Сверху всегда ложится место под ваш текст, и чем он длиннее, тем больше надо. День, чтобы узнать то, что считается в 2 строки
На диске влезло. А в памяти?
«У меня же терабайт!»
А модель просила оперативную память
Скачать файл и запустить модель - разные задачи. Смотрим, какая именно память нужна и сколько её свободно
Влезла по весу, но не работает
nemotron-mini
Эта модель помещалась в память с запасом и упала мгновенно. Причина оказалась в третьем параметре, о котором я тогда не думал
Окно контекста 4096
Окно это сколько текста модель держит перед глазами одновременно. Здесь помещается около 1500 слов, и это вместе с инструкцией. Наша запись - 7383 слова, и даже пятая её часть внутрь не влезла
Ловушка страшнее самого падения
Падение хотя бы видно. Хуже другое: во многих сборках длинный текст режется молча и с начала. С начала - значит теряется ваша инструкция. Модель отвечает уверенно и связно, не увидев задания. Ни ошибки, ни следа в журнале
Отработала честно и вернула ничего
gemma3:4b
Модель подходила по всем параметрам. Считала 10 минут и вернула 0 фрагментов из 5 частей записи
- Ломалась на требовании вернуть ответ строго заданной формы: ей нужен был список номеров, а она его не держала
- Позже, на другом прогоне, она же заполнила 22 поля и выглядела лучшей из всех. К этому вернёмся: там была ловушка
Где здесь врут 5 раз подряд
Слово «готово» тут врёт. 5 частей отработали успешно и вернули ничего. Пустой ответ обязан отличаться от отказа прямо в коде, иначе о поломке вы узнаете от клиента
68 минут пусто. Потом 368 минут пусто
ruadapt делала выписки из текста: 163 фрагмента, то есть подход рабочий. А раскладка по разделам дважды упёрлась в отсечку по времени. Я решил, что времени мало, и поднял лимит втрое
Цифра показывала мою отсечку, а не модель
68 при лимите 30 и 368 при лимите 90. В обоих замерах я измерял собственный предел терпения, а не скорость модели. Поднять лимит не значит вылечить: тот же обрыв просто отодвигается
Как надо было, и я это знал
Взять один маленький кусок текста, замерить время, умножить. Минута работы вместо 6 часов ожидания. Этот приём я применяю в других проектах - и не применил здесь, потому что был уверен, что вот-вот пойдёт
Модель думает. Я тоже
«Ещё чуть-чуть подожду»
368 минут спустя: пустой файл
Здесь смешно, пока ждёшь мем. Когда ждёт клиент, нужны предел ожидания и понятный отказ
Модель не упала, а ушла считать на диск
Лимит памяти 4 ГБ, модель занимает 5,4 ГБ. Я ждал падения с понятной ошибкой. Получил тишину
Признак, по которому ловить
Когда памяти не хватает, система начинает использовать диск как память. Это в сотни раз медленнее и выглядит как работа. Буква D в состоянии процесса означает «ждёт диск». И смотрите на загрузку: при счёте с диска она не растёт, а падает вдвое. Процессору нечего делать, он ждёт
4 провала, 4 разные причины
| Модель | Что видел я | Настоящая причина | Чем ловится за минуту |
|---|---|---|---|
| qwen2.5:14b | ошибка 500 через 2 мин | вес плюс место под текст больше памяти | ollama ps и свободная память |
| nemotron-mini | мгновенное падение | окно контекста 4096 | длина текста в токенах до отправки |
| gemma3:4b | пусто за 10,6 мин | не держит заданную форму ответа | счётчик фрагментов, а не код ответа |
| ruadapt | 68 и 368 мин пусто | считала на диске, обрыв по отсечке | состояние процесса D и docker stats |
Общее у всех 4 моделей: ни одна не сказала, что ей плохо.
Отказ выглядел как работа, а причина лежала в команде, которую я не додумался запустить
5 стадий принятия локальной модели
Отрицание
Модель не отвечает, но это точно что-то с конфигурацией
Гнев
Она отработала и вернула пустой файл. 5 раз подряд, и все 5 раз «успешно»
Торг
Поднимаем отсечку втрое. Потом ещё. Потом ещё чуть-чуть
Депрессия
368 минут. Пустой файл. 7 с половиной часов суммарно
Замер
Вместо принятия - таблица. 4 модели, 4 причины, и решение перестаёт быть вопросом веры
Шутка в том, что стадии 1-4 заняли 2 недели, а стадия 5 - один вечер. Если бы я начал с пятой, доклада бы не было
Влезет ли модель в вашу машину
Подвигайте 4 ползунка: память, вес модели, размер окна и длина текста. Это учебная прикидка, а не замер вашей машины. Кнопки подставляют примеры параметров моделей из кейса
Запись сессии в 7383 слова это около 20 000 токенов. Подвиньте последний ползунок туда и посмотрите, что будет.
В учебной формуле вес умножается на 1,35, к нему добавляется 0,12 ГБ на 1000 токенов окна. Реальный расход зависит от модели и настроек - его надо замерить
Порядок проверки в жизни: сначала окно, потом память, и только потом качество. Первые два отсекают за минуту, третье стоит часов
Очевидный ответ стоил бы денег клиента
Модели не хватает памяти. Напрашивается более мощный сервер. Это счёт клиенту, доступ к чужой панели хостинга и простой сервиса на время переезда
Сначала ищем память внутри того, что уже куплено
Прежде чем выставлять счёт клиенту, я полез смотреть, сколько уже оплаченного лежит без дела. Лежало больше гигабайта - мой же, забытый мной
Вывод команды восстановлен по памяти: точный снимок того дня в журнале проекта не сохранился. Проверено и записано другое - сервер 6 ГБ, ollama в диск-памяти вместо оперативной, и найденный гигабайт, из которого собрался запас
Откуда взялся гигабайт
Мёртвый запас у бота
Я выделил боту 2 ГБ, ест он 7 МБ. Запас ставил, когда бот сам распознавал речь. Потом работу забрал другой модуль, а запас так и стоял - подписанный мной и никому не нужный
+1 ГБМодель не выгружалась
Время удержания я не задал вообще, работала подстановка по умолчанию. Модель висела в памяти 5 минут после каждого ответа и сталкивалась там с распознаванием следующей записи. Поставил 30 секунд
конфликт снятМесто под ответ втрое больше нужного
Под ответ модели я зарезервировал 8000 токенов - на глаз, с запасом. Реально нужно около 2000. Теперь считаю по самой форме ответа: 1 группе 2100, разделам 2700
окно вырослоОбщая сумма выделенной памяти при этом не изменилась.
Я ничего не докупал и ничем не рисковал: просто убрал за собой. Гигабайт, которого мне не хватало, весь вечер лежал в моих же настройках
Что изменилось за 1 вечер
| Показатель | Было | Стало | Что это значит |
|---|---|---|---|
| Состояние процесса | D · ждёт диск | R · работает | перестали считать на диске |
| Процессор | 108% | 266% | машина занята делом, а не ожиданием |
| Занято в диск-памяти | 2254 МБ | 318 МБ | главный показатель, за которым стоит следить |
| Модель в памяти | 5,3-6,4 ГБ | 4,7 ГБ | при этом окно контекста стало больше |
Запросы пошли
Раньше были только отказы через 30 минут. Стало: ответы за 3-15 минут. Модель ожила
И всё равно не дошла
Прогон на 368 минут был до этой починки. После неё запросы пошли за 3-15 минут, а ещё через полтора часа модель снова уехала на диск. Ожившая не значит работающая
На этом сервере не справилась ни одна из 4 моделей
В таблице осталось, что произошло с каждой моделью и как это проверить. К этим результатам можно вернуться, если будем пробовать снова
Что показал тест
Для этой записи на этом сервере рабочего варианта не нашли. Делать вывод обо всех локальных моделях по четырём попыткам я бы не стал
Что ещё можно проверить
Заполнять карточку по одному разделу за запрос. Попробовать модель с большим окном контекста на сервере с видеокартой
Эти варианты я не тестировал. Стоимость аренды такого сервера тоже не считал
Следующий вариант - облачная модель
Перед отправкой нужно решить, какие данные ей передавать
Чем вообще мерить модели
2 карточки выглядят одинаково прилично. Как понять, какая лучше, не читая запись 7 раз подряд
Как понять, какая модель справилась лучше
Вот две карточки, сделанные разными моделями по одной записи. Обе выглядят прилично. Обе написаны уверенно. Какая лучше?
«Посмотрю и пойму»
Глазами не отличить. Гладкий текст ещё ничего не доказывает: модель может убедительно написать то, чего в записи не было. Поэтому каждое поле надо сверять с исходной записью. Одного впечатления «звучит хорошо» мало
Завести линейку и мерить ею всех одинаково
Линейка - это несколько чисел, которые считает код, а не человек и не модель. Одна и та же запись, одни и те же числа, результаты в таблицу
Главное свойство линейки
Она пишется до того, как увидели результаты. Иначе происходит подмена: сначала прогнали модели, потом посмотрели, у кого что получилось, и назвали хорошим то, что вышло у понравившейся. Замер превращается в её оправдание
Как это было у меня
Порог записан 19 августа, замеры сделаны 20-го. И после замеров порог не двигался, хотя очень хотелось
Почему хотелось: та связка моделей, которой клиент пользовался целый месяц, этот порог не взяла ни разу. 12 карточек из 12 ниже планки. Неприятно, зато правда
Из чего состоит моя линейка
Опора на запись
Берём каждое утверждение из карточки и ищем ему подтверждение в расшифровке записи. Доля тех, что нашлись, и есть опора
Ловит: выдумку. Если модель дописала от себя, опора падает
Худшее поле
То же самое, но не в среднем по карточке, а по самому слабому полю
Ловит: перекос. Среднее 80% бывает при 9 отличных полях и одном полностью выдуманном. Для человека это одно испорченное поле, а не хорошая карточка
Цитаты дословные
Если модель приводит цитату клиента, эта фраза обязана найтись в расшифровке дословно, символ в символ
Ловит: пересказ под видом цитаты. Это то, что человек может проверить глазами за секунду
2 утверждения из 3 подтвердились расшифровкой: опора этого поля 67%. Третье модель дописала от себя - именно это ловит первое число линейки. И считает его код, а не модель: спрашивать у модели, хорошо ли она справилась, всё равно что спрашивать у ученика, доволен ли он своей работой
3 дыры в моей линейке
Не видит, в тот ли раздел положено
Опора спрашивает «есть ли эти слова в записи». Слова из рассказа про работу, положенные в раздел про 7, дают опору 90% и полностью неверную карточку
запомните эту дыру, через полчаса она выстрелит
Не наказывает за пустоту
Модель, которая заполнила 2 поля из 30 идеально, получает прекрасную опору. Молчун выигрывает у работяги
пришлось считать полноту отдельно
Не измеряет осмысленность
Специалист сказала про 1 карточку «ближе к сути». Что такое суть, числом не выражается. Линейка тут бессильна по устройству
решает человек, и это нормально
Линейка не заменяет человека. Её работа - отсечь заведомо негодное, чтобы человек смотрел не 7 вариантов, а 2
На выдуманном тексте модель справилась лучше
Сначала я попросил модель сочинить сессию для пробного теста. Потом дал настоящую запись почти той же длины. Проверял ответы одинаково
7043 слова
Темы названы прямо, речь ровная, никто никого не перебивает. Такой текст проще разобрать
7383 слова
Люди перебивают друг друга, возвращаются к темам. Ответ на вопрос из начала может прозвучать в конце
На настоящей записи результат ниже на 16 процентных пунктов
Пробный текст полезен для отладки. Качество проверяем на живой речи
Теперь проверяем 3 модели GigaChat
Локальные модели результата не дали. Следующий шаг - сравнить облачные модели на той же записи и по тем же критериям
GigaChat-2
Базовая модель линейки. Проверяем, хватит ли самой дешёвой: если да, остальные не нужны
GigaChat-2-Max
Та же линейка, больше параметров. Смотрим, что даёт доплата на нашей задаче, а не на рекламных тестах
GigaChat-3-Ultra
Топовая на момент замера. Если и она не возьмёт порог, вопрос закрыт для всего российского облака
Что считаем
Заполненные поля из 30, использованные разделы из 13 и опору: доля утверждений, подтверждённых записью
Условия одинаковые
Одна и та же запись в 7383 слова, один промпт, одна форма ответа. Иначе сравнение превращается в соревнование промптов
Что меня здесь ждало
Я ожидал линейку «хуже - лучше» по размеру модели. Получил другое, и это следующий слайд
Три модели прочли один текст и нашли разное
Я сравнивал модели, чтобы выбрать лучшую. И увидел вот что: на моём тексте у каждой модели были свои пропуски. Каждая вытаскивает свой кусок разговора, а остальные его не замечают. Поэтому выбирать надо на своей задаче: какой ответ полезнее и какие пропуски дороже исправлять
По полям
Все 3 нашли одно и то же в одном поле из 30
По разделам
Общего нет вообще: ни одного раздела, который заполнили бы все 3
Если сложить 3 вместе
16 полей из 30 и 7 разделов из 13 против 11 и 6 у лучшей одиночной
Одна запись, 7 моделей, одна линейка
| Модель | Где считает | Опора | Полей из 30 | Разделов из 13 | Цитаты | Время | Итог |
|---|---|---|---|---|---|---|---|
| gemma3:4b | локально | нет | 0 | 0 | нет | 10,6 мин | пусто |
| nemotron-mini | локально | нет | нет | нет | нет | мгновенно | окно 4096 |
| qwen2.5:14b | локально | нет | нет | нет | нет | 2 мин | не влезла |
| ruadapt | локально | нет | 0 | 0 | нет | 368,2 мин | пусто |
| GigaChat-2 | облако РФ | 51% | 2 | 2 | 8 из 8 | быстро | ниже порога |
| GigaChat-2-Max | облако РФ | 61% | 11 | 3 | 0 | быстро | ниже порога |
| GigaChat-3-Ultra | облако РФ | 73% | 11 | 6 | 13 из 13 | 1,3 мин | взял порог |
Что значит «нет» в клетке
Модель не дошла до результата, мерить было нечего. Это не ноль качества, это отсутствие ответа: карточки не существует
Что значит «0» у цитат
Так у GigaChat-2-Max: ответ есть, цитат в нём нет ни одной. Модель пересказывает своими словами, и проверить глазами нечего
Худшее поле у победителя 45% при пороге 40%. Все цифры на одной и той же записи в 7383 слова
2 карточки одной сессии. Какую выбрали бы вы?
Обе сделаны машиной по одной и той же записи. Смотрите на то, что видно заказчику. Напишите в чат А или Б. Затем разберём, откуда взялись слова
А выглядит убедительнее: полей вдвое больше. Но полнота ещё не значит, что модель сказала правду
На следующем слайде видно, что стоит за этими 2 карточками. Разница не в старательности модели, а в том, откуда взялись слова
Почему я выбрал модель, которая заполнила в 2 раза меньше
Карточка выглядит полной и аккуратной. Но Три четверти написанного в записи не звучало. Модель дописала за клиента то, что обычно говорят такие люди
специалист: «отсебятину несёт»
Половина полей пустая. Зато большая часть написанного опирается на запись, и 13 цитат из 13 нашлись в записи дословно
пустое поле специалист заполнит сам
Да, это та самая gemma3:4b, которая в главной таблице стоит с нулём. В челлендже она не выдала ничего, а на другом прогоне, с более простой формой ответа, заполнила 22 поля. Обе цифры настоящие, и вторая опаснее первой
Если бы я считал качество полями, я бы выбрал сочинителя
Если считать качество по числу заполненных полей, побеждает тот, кто больше выдумывает. В карточке живого человека выдуманное поле хуже пустого: пустое видно сразу, а правдоподобное прочитают и пропустят
Я знаю, как сделать лучше, и намеренно не делаю
Каскад: спрашиваем по очереди
Первая ответила - остальные молчат. Защищает от отказа провайдера: упал 1, ответит второй. Сам по себе такой порядок не улучшает содержание: вы получаете первый успешный ответ
Ансамбль: спрашиваем всех сразу
Отвечают все, ответы складываются в 1. Защищает от пропусков, и мой замер показывает, что пропуски тут главная беда
Почему я на него не бросился
- цена разбора умножается на число моделей
- время растёт до самой медленной из них
- появляется новая задача: как слить 3 карточки в одну, если они противоречат друг другу
- у бесплатного тарифа провайдера 1 поток, а запросов на 1 сессию уже 11
Больше найденных полей. Но окупится ли это?
В замере ответы вместе дали плюс 5 полей и 1 раздел. Это запас полноты, а не доказательство, что карточка стала удобнее. До включения надо сравнить цену запросов со временем, которое они сэкономят специалисту. Ручное время я пока не замерил
Сообщение, которое отменило мои цифры
2 недели показатели росли, я был доволен собой. Потом написал человек, который этим пользуется
2 месяца одной задачи
Это не эксперимент на досуге. Всё время внизу - живой проект с клиентом, который каждый день записывал сессии и ждал карточки
Старт
Первая архитектура: бот, очередь, локальное распознавание
Первый провал
Модель не влезла в ноутбук. Думал, что дело в машине
Записал линейку
Пороги качества на бумаге до первого замера
368 минут
Самый дорогой прогон. Пустой файл
Локальное закрыто
Не мнением, а таблицей из 4 моделей
Сообщение клиента
«Слова мои, но всунуты в другие рубрики»
Нынешняя схема
Разбор целиком, 77% опоры, 4-8 ₽ за сессию
Что шло параллельно
Клиент всё это время работала. Каждая моя ошибка стоила ей либо лишней ручной правки, либо испорченной карточки
Сколько стоила разработка в токенах
Замеры и прогоны за 2 месяца - меньше 1500 ₽. Дорого обошлось не железо и не модели, а моё время
Главный расход
2 недели ушли на путь, который закрывается таблицей за 1 вечер. Ровно про это весь доклад
Мы резали каждую запись на 3-5 кусков
Нашу запись резало на 5 частей. Нарезку придумали под локальную модель: целиком она текст не брала. Лекарство было от тесноты машины, а не способом разбирать лучше
Локальную модель убрали, а нарезка осталась
Размер куска был записан числом: 5500 токенов, кто бы ни разбирал. Облако получало разрезанную запись, хотя давно могло взять её целиком
Чем это платилось
| Как разбирали | Полей | Разделов |
|---|---|---|
| по кускам | 19 из 29 | 10 из 13 |
| целиком, одним запросом | 27 из 29 | 12 из 13 |
| вручную, специалистом | 26 из 29 | 10 из 13 |
Третья строка важна: разбор целиком оказался полнее ручного разбора, сделанного человеком с записью перед глазами
Полей здесь 29, а не 30: этот замер шёл по карточке той версии, где одно поле ещё не было заведено. Знаменатель одинаковый у всех трёх строк, сравнение честное
Сессия это связный разговор. Запрос звучит в начале, ответ на него в конце. Разрез теряет именно связи
Число в коде не спрашивает, зачем оно там стоит
Почему нельзя записать число
Записанная цифра вернула бы нарезку облаку молча при следующей же правке. Настройка, которую надо не забыть поменять, обязательно будет забыта
Почему нужен аварийный выход
Сколько текста берёт облачная модель, нигде не написано. Значит «влезет» это предположение, а у предположения обязан быть запасной ход. Разрезать хуже, чем целиком, но несравнимо лучше, чем потерять запись
Решение живёт дольше причины, по которой его приняли. Пишите причину рядом
Победитель челленджа проработал в бою 2 недели
Я поставил GigaChat-3-Ultra боевым, довёл опору до 77%, разделы до 9 из 13. Цифры росли, я был доволен собой. Потом пришло сообщение от специалиста
Дальше она написала, что про названную тему вообще не говорила, а машина её вписала и развернула разговор в другую сторону: впечатление от встречи вышло совсем другим. И добавила фразу, от которой мне стало совсем неуютно: самые первые разборы были самые лучшие. Самые первые делал человек вручную, без всякой модели
Проверил, и стало хуже
Из 20 заполненных разделов в 7 свежих карточках 3 раздела заполнены при полностью отсутствующей теме. То есть модель взяла настоящие слова и положила их туда, где им не место
А линейка молчала
Опора у этих карточек была прекрасная. Слова-то настоящие, они в записи есть. Линейка спрашивает «звучало ли это», а не «в том ли разделе оно лежит»
Я 2 недели улучшал то, что клиент не считает проблемой
Опора росла: 73 → 77%. Разделы росли: 6 → 9 из 13. Все мои цифры шли вверх. А продукт в это время становился хуже для того, кто им пользуется
Линейка измеряла честность, а не смысл
Модель не врала: она брала подлинные слова. Она их неправильно раскладывала. Это другая беда, и у моей линейки для неё не было числа вовсе
Что с этим сделали
- Сначала попробовали поменять модель. Об этом следующий слайд, и там всё оказалось не так, как я думал
- Потом поняли: раскладка задаётся описанием разделов, а не мощностью модели. Описание пишет специалист своими словами, а не я
- 6 первых полей карточки отдали человеку совсем: их теперь заполняет специалист, машина туда не лезет
Тест пришлось собирать по частям
Полную запись не пропустили
Провайдер пропустил короткий фрагмент, но отклонил настоящую сессию целиком
поэтому запись пришлось резать
Один шлюз не ограничил ответ
Формат ответа не применился. Модель выдала 155 000 символов и оборвала результат
это сбой инструмента
Полный замер не удалось завершить
Сервис перестал принимать запросы. Замер на полной записи остановился
причину отказа нужно проверить в сервисе
Из-за первой проблемы я резал запись. Думал, что дело в памяти, но причина оказалась в фильтре провайдера
Почему в итоге стоит зарубежная модель
Российское облако отсекло само себя
Фильтр провайдера не пропускает настоящую сессию целиком. Значит либо резать и терять связи, либо уходить
Замер на одной записи
GigaChat по кускам: 19 полей из 29, 10 разделов.
claude-haiku-4.5 целиком: 27 из 29, 12 разделов
Проверка, что уходит наружу
Перед отправкой найденные персональные данные заменяются обозначениями до отправки. Замер на 16 записях: остатков вида «Фамилия И.» 0. Оговорка, которую я обязан произнести: такой поиск не поймает искажённое написание, поэтому «остатков нет вообще» я утверждать не могу
И попутная находка, из-за которой я потерял 2 недели
Доступ к сервису уже был настроен на сервере. Но мой скрипт искал файл с настройками в другой папке и сообщал, что доступа нет. Ошибка была в проверке настроек, а не в отсутствии доступа
Сначала проверяйте саму проверку: действительно ли она смотрит в рабочую папку
Из 394 моделей у шлюза ни одной с нужной отметкой
В облако уходит текст с заменёнными именами
Перед отправкой сервис заменяет найденные персональные данные служебными маркерами, например [ЛИЦО_1]. Модель получает этот текст, а таблица обратных замен остаётся в памяти процесса на нашем сервере
В этом проекте голос остаётся на сервере
Наружу пошёл бы голос человека. Вырезать из голоса нечего: он сам и есть примета. Заменить имя на обозначение можно, заменить голос на обозначение нельзя - это уже будет не запись, а тишина
4 локальные модели не справились с заполнением карточки на этом сервере. Но локальным осталось главное: данные не покидают сервер, а результат можно проверить и повторить
И честное уточнение, которое обычно проглатывают
То, что мы делаем с текстом, строго говоря не обезличивание. У нас ключ соответствия лежит на своём сервере: связь с человеком можно восстановить. Замена имён не означает, что в тексте больше нет личных сведений. Поэтому отдельно проверяли согласие, замену до отправки и состав уходящего текста
И общая оговорка: я рассказываю, что делали мы в своём проекте. Это не юридическая консультация, за схему конкретного бизнеса отвечает его юрист
Что из этого работает каждый рабочий день
Запись
Грузится сразу на свой сервер, минуя мессенджеры
свой контурРаспознавание
Локально, large-v3-turbo. 47 минут записи за 25 минут счёта
0 ₽ · голос не уходитЗамена имён
ФИО и даты становятся обозначениями. Ключ остаётся у нас
граница контураРазбор
Целиком, одним запросом, claude-haiku-4.5
наружу · 8,14 ₽Цифры последней рабочей сессии: запись на 3733 слова, 21 сентября. Не лабораторный замер, а обычный день
Машину измерили. Специалиста пока нет
Карточка готова за 14 минут. Но цель проекта - не больше 5 минут работы специалиста: проверить карточку и исправить ошибки. Это время пока не замерено, поэтому выполнение цели ещё не подтверждено
Деньги, данные и кто находит поломки
Сколько стоит 1 разбор, почему дороже не значит лучше и почему главную цифру проекта я так и не замерил
Разброс цены в 150 раз за одну и ту же работу
| Модель | Цена разбора | Против нынешней | Что получаете за доплату |
|---|---|---|---|
| gpt-5.6-luna | 2,77 ₽ | в 3 раза дешевле | опора 74%, но в 2 раза меньше цитат |
| claude-haiku-4.5 в бою | 8,14 ₽ | - | опора 77%, 12 разделов, 10 цитат из 10 |
| gemini-3.6-flash | 8,95 ₽ | +10% | примерно то же самое |
| claude-sonnet-5 | 23,87 ₽ | ×2,9 | ту же раскладку по тому же описанию |
| gpt-5.6-terra | 27,69 ₽ | ×3,4 | то же самое |
| claude-opus-5 | 59,69 ₽ | ×7,3 | то же самое |
| gpt-5.5-pro | 415,37 ₽ | ×51 | то же самое |
Считано по длинной записи: 20 091 токен на входе, около 16 000 на выходе. Исторический расчёт на 10 сентября 2026, не текущий прайс.
Почему тут 8,14 ₽, а на прошлом слайде было 4,41 ₽: цена прямо зависит от длины. 3733 слова обошлись в 4,41 ₽, 7383 слова - в 8,14 ₽. Вся таблица посчитана на длинной записи, чтобы модели сравнивались между собой честно
Как выглядит разброс цены, если нарисовать его честно
Длина полосы - настоящее соотношение цен. Верхние 4 почти не видно, и это не ошибка отрисовки: они в десятки раз дешевле последней
Пример: 20 сессий в месяц
20 сессий на самой дорогой
Что это значит на практике
В этом расчёте 20 разборов стоят от 55 до 8300 ₽. Более высокая цена сама по себе не доказывает, что специалисту будет удобнее работать с карточкой
«Возьмите модель помощнее» Часто это неверный совет
Так советуют почти всегда, когда результат не нравится. Разберём на нашей претензии, почему это не сработало бы
- Претензия звучала так: слова мои, но не в тех разделах
- Опора при этом уже 77% при пороге 70, цитаты 10 из 10 дословные
- Многие слова подтверждаются записью. Но это ещё не проверка, в какие разделы их положили
- И кладёт не туда. А куда класть, ей говорит описание разделов, которое написал я
- Более дорогая модель получит то же описание. Нет гарантии, что она поймёт разделы так, как специалист
Что делаем вместо апгрейда
Просим специалиста описать разделы её словами: какими фразами про каждый раздел говорят на сессии. Это требует её времени, которое я пока не замерил. И упирается в занятость человека, а не в технологию
«Вы сохраняете текст моих запросов?»
Мы отправили этот вопрос российскому провайдеру 20 августа. Ответа не было. Подготовили второе письмо, жёстче и с прямой просьбой ответить письменно. На момент подготовки кейса в сентябре 2026 ответа не было
Молчание не защищает
Если запросы сохраняются, наше незнание ничего не меняет для клиентов центра. Зато письменный запрос без ответа - это уже документ, а не предположение. Он показывает, что оператор спрашивал
3 вопроса провайдеру до интеграции
- Сохраняете ли вы текст запроса и на какой срок
- Где физически стоят серверы, на которых идёт вычисление
- Можно ли выключить сохранение и подтверждается ли это документом
Третий вопрос самый полезный. У одного из наших провайдеров сохранение запросов оказалось включено по умолчанию и выключалось настройкой. Мы выключили. Если бы не спросили, не узнали бы никогда
Как специалист перевернула мою таблицу
Три карточки одной и той же сессии ушли ей без подписи, какой моделью сделана каждая. Я был уверен, что знаю, какую она выберет
| Её оценка | Модель | Опора | Полей | Цитат |
|---|---|---|---|---|
| «никуда не годится» | GigaChat-2 | 51% | 2 из 30 | 8 из 8 |
| «ближе к сути» | GigaChat-2-Max | 61% | 11 из 30 | 0 |
| «тоже хорошо» | GigaChat-3-Ultra | 73% | 11 из 30 | 13 из 13 |
Совпало на браке
Худшую по цифрам она забраковала наотрез. Линейка надёжно отличает негодное
Разошлось на лучшем
Первое место она отдала модели, которая проигрывает 12 пунктов опоры и не дала ни одной цитаты
Что это значит
Опора ловит выдумку, но не измеряет осмысленность. «Ближе к сути» числа не имеет
Если бы я выбирал только по таблице, клиент работал бы с карточкой, которая ей неудобна.
Цифра отсеивает негодное, выбирает человек
Как проверить сервис после обновления?
Открыть главную страницу
Посмотреть журнал ошибок
Загрузить запись и получить карточку
Вы обновили сервис разбора сессий. Как проверите, что им можно пользоваться? Напишите 1, 2 или 3
Показать разбор после ответов
3: загрузить запись, дождаться обработки и получить карточку. Страница может открываться, пока загрузка или сохранение сломаны. Журнал полезен, но результат подтверждает полный путь
Главная цифра проекта не про качество модели
Я веду отдельный список: кто первым обнаружил каждую поломку в работающем сервисе. Вот счёт
26 проверок есть. Сколько сбоев они поймали?
Автоматические проверки первыми нашли 2 поломки из 16, то есть 12,5%. Остальные нашли клиент, я или агент. Считать надо пойманные сбои, а не количество проверок
19 часов простоя нашёл клиент
2 записи повисли между этапами. Конвейер отработал честно, ничего не потерял и промолчал. Узнал я из сообщения: «загрузила 2 аудиозаписи, но их нет в итоге»
Клиент 20 раз нажала «сохранить»
Ключ не сохранялся: папка принадлежала не тому пользователю. Мы проверяли выкат чтением, а запись не проверили ни разу. Цена - сутки простоя и потерянное доверие к кнопке
Сторож это маленькая проверка, которая бежит сама
Каждый сторож отвечает на один вопрос и умеет сказать три вещи: всё хорошо, стоит посмотреть, беда. Плюс что именно делать. Все 26 складываются в одну строку, которую я читаю утром вместо кофе - и это помогает узнавать о поломках раньше клиента
Диск, память, нагрузка
Скучные, но именно они ловят «сервер кончился». Плюс сторож живых контейнеров
Бэкап и приёмник
Бэкап делается и распаковывается, записи не висят между этапами, дублей нет, аудио не копится
Кабинет и деньги
Кабинет открывается, кабинет умеет записывать, счёт не кончается, карточки доезжают
Доступ и словарь
Сертификат жив, вход не ломают, термины не коверкаются, данные принадлежат сервису
Два правила, до которых пришлось додуматься отдельно
Первое. Сторож обязан сообщать не только о беде, но и о том, что сам ослеп. Молчащий сторож и здоровый сервис выглядят одинаково
Второе. Тревога приходит с разбором, а не с заданием разобраться. Не «посмотрите журнал», а «вот что в журнале, вот вывод». Смотреть должен код, у которого данные уже в руках
Сторож, который врёт, хуже отсутствующего
Все 6 строк ниже - это зелёные галочки, за которыми ничего не стояло. Мой мониторинг полгода докладывал, что всё прекрасно, и формально не врал: он честно отвечал на вопрос, который ему задали
| Что сторож говорил | Что было на самом деле | Почему так вышло |
|---|---|---|
| «Попыток взлома: 0» | 3 отказа подряд в тот же час | Читал не тот журнал. Настройка по умолчанию смотрела в системный, а записи шли в файл |
| «Отправлено успешно, телеграм: нет» | Ни одна тревога не доходила до меня | Службе не передали настройки окружения. Она честно отработала и честно не отправила |
| «Кабинет доступен» | Правки клиента не сохранялись сутки | Проверялось право записи в папку, а сломан был файл внутри неё |
| «Подозрительных входов 7, смените пароль» | Ни одного входа. Это были боты-сканеры | Считал попытки, а не входы. Дорогой совет по косвенному признаку |
| «Всё чисто, ошибок нет» | Сторож не работал вовсе | После полуночи брал вчерашний журнал и не находил в нём сегодняшних событий |
| «Словарь терминов: 0 правок» | Правок и правда 0, но узнал я это через месяц | Счётчик нуля не отличает «всё хорошо» от «проверка не работает». Пришлось делать замер |
Общее у всех шести: зелёный статус при сломанной работе.
Проверять надо артефакт, а не статус: не «служба запущена», а «вот файл, который она должна была создать»
Мой же ИИ-агент сломал загрузку записей своей собственной починкой
Агент чинил данные на боевом сервере и запустил починку от имени главного пользователя. Служебный файл после этого стал принадлежать ему, а сервис работает под другим пользователем
Клиент в это время работала вслепую: грузила записи, а они не появлялись
Правило, которое из этого выросло
Починку данных не запускать от имени главного пользователя. Никогда, даже когда «так быстрее». Опечатка в такой команде бьёт по всей системе, а не по одному файлу
И более общее, для всех, кто работает с агентами
Уверенный агент тоже может выполнить опасное действие. Опасные права, боевые данные и внешние действия - это подтверждение человека, а не вопрос формулировки задачи
Материалы к докладу включают готовую инструкцию для вашего ИИ-агента: что именно ему запретить, чтобы он не повторил это у вас
«Все тесты прошли»
А клиент: «загрузила запись,
но её нет»
Уверенный отчёт агента - повод проверить результат самому. Тест должен пройти тем же путём, которым идёт клиент
Бинго «со мной такое было»
Отметьте знакомые грабли и напишите в чат число от 0 до 9. Я отмечаю 9 из 9
8 правил, каждое оплачено моим временем
Порядок, в котором я бы делал это заново
Померьте длину своего текста
Больше окна модели - эта модель вам не подходит ни при каком железе. Дальше можно не читать
Сложите вес модели и место под текст
Сравните со свободной памятью, а не с общей. Если диск-память уже занята, памяти у вас нет
Напишите линейку и порог
Что считается хорошим результатом и каким числом это меряется. Считает код. До первого замера
Прогоните всех на одном живом примере
Не на выдуманном. 1 вход, 1 линейка, результаты в таблицу
Отдайте лучшие на слепую вычитку
Без подписей, тому, кто будет этим пользоваться. Его выбор может не совпасть с таблицей, и прав будет он
Спросите провайдера про данные
Хранение запросов, где серверы, можно ли выключить. Ответы сохраните письменно
Шаги 1 и 2 позволяют отсеять неподходящие варианты до длинного прогона. Я потратил на них 2 недели, потому что делал в обратном порядке
Что проверите первым после эфира?
Какие данные уходят наружу
Память и длину входного текста
Качество на настоящем примере
Полный путь клиента
Напишите цифру и 1 фразу: «3 - сравню карточку с записью». Выберите 1 проверку, которую сможете сделать первой
Что забрать с собой прямо сейчас
Правила для вашего ИИ-агента
Инструкция для вашего кодящего агента: проверки до запуска, запреты на боевом сервере и что сообщать при отказе
формат .md, кладётся в проект
Чек-лист проверки модели
6 шагов по порядку: что считать, чем мерить, кому показывать и что спросить у провайдера до интеграции
1 страница, для печати
Симулятор памяти
Посчитайте, влезет ли модель в ваш сервер, ещё до того как её качать. Пресеты воспроизводят настоящие замеры из этого кейса
ссылка живёт после эфира
Где меня найти
- Телеграм для связи: @ganimarketing. Пишите с вопросом по своему проекту, отвечаю сам
- Канал «Neuromag AI»: @neuromag_ai. Разборы ИИ-инструментов и находки из боевых проектов
- Сайт: ganimar.ru
Если у вас задача с данными, которые нельзя отдавать наружу, напишите. Скажу честно, решается она сегодня или пока нет